


کارگاه آموزشی بازیابی اطلاعات و موتورهای جستجو تهران 96
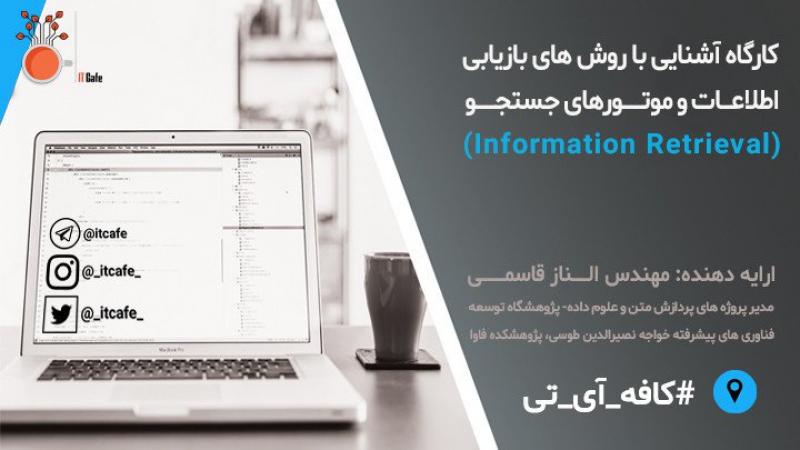
زمان برگزاری کارگاه آموزشی بازیابی اطلاعات و موتورهای جستجو ؛ تهران - در محل کافه آی تی واقع در خیابان آفریقا ( جردن شمالی)، بعد از پل میرداماد، بن بست قبادیان شرقی، پلاک 3، ساختمان شرکت فناپ - از تاریخ 20 تا 29 دی ماه 96 میباشد .
کارگاه آشنایی با روش های بازیابی اطلاعات و موتورهای جستجو (Information Retrieval)
مروری کوتاه بر ادبیات مسأله:
داده های متنی ازین جهت حائز اهمیت هستند که توسط انسان تولید می شوند، نه توسط حسگرها یا رایانهها. همینطور از سوی دیگر این دادگان مورد استفاده انسان نیز هستند. بنابراین یافتن دانش پنهان در اینگونه از اسناد و بهره گیری از سیستم های هوشمند، میتوان به انسان در تصمیم گیری بهتر و دقیقتر در همه جوانب یاری رساند.
بازیابی اطلاعات (Information Retrieval) فناوری و دانش پیچیده جستجو و استخراج اطلاعات، داده ها و فراداده ها ازمنابع گوناگون اطلاعاتی و با فرمت های مختلف (نظیر متن، صوت و تصویر) است. در این میان موتورهای جستجو به عنوان ابزاری هوشمند، کمک میکنند تا افراد بتوانند حجم انبوه دادگان را اصطلاحا digest کند. ساختارمند بودن یا نبودن دادگان در این مبحث اهمیت فراونی دارد؛ زیرا تفاوت دانش بازیابی اطلاعات و بازیابی دادگان ( از پایگاه داده ها) از همین موضوع ناشی میشود.
باتوجه همه آنچه گفته شد، هدف نهایی کمک به کاربران در دستیابی به دادگانی است که از میان حج انبوه دادگان، بیشترین تطابق را با نیاز آنها دارد.
اهداف دوره:
درک مفاهیم اصلی و الگوریتم های بازیابی اطلاعات ( و بطور خاص بازیابی متون)
تفاوت بازیابی اطلاعات (IR) و بازیابی دادگان (DR)
آشنایی با پردازش زبان طبیعی (NLP)، به عنوان دانش پایه جهت بازیابی متون
چگونگی تبدیل حجم انبوه دادگان خام به زیرمجموعه کوچکی از دادگان مرتبط با نیاز کاربر
چگونگی مدلسازی اطلاعات
چگونگی تعیین میزان ارتباط هر سند با توجه به نیاز کاربر
بررسی معیارهای ارزیابی بازیابی متون
ارائه دهنده:
پژوهشگر ارشد علوم داده(مدیر پروژه های پردازش متن و علوم داده- پژوهشگاه توسعه فناوری های پیشرفته خواجه نصیرالدین طوسی، پژوهشکده علوم داده)
مترجم کتاب های:
جاوای کاربردی Effective JAVA
راهکارهای برنامه نویسی در قالب 150 مسئله و راه حل
مرجع کامل Linux
مرجع کامل جاوا (هربرت شیلد)
برگزارکننده:
کافه آیتی
خدمات کافه آی تی به استارت آپ ها و ایده پردازان:
کارگاه های آموزشی
منتورینگ
فضای کاری
برگزاری رویداد (startuptime)
تیم سازی و شبکه سازی
لینک ثبت نام:
رویداد های مرتبط
-
کارگاه آموزشی هوش مصنوعی شیراز خرداد 1404 ... (برگزار شده)
22 خرداد 04 شیراز
-
کارگاه آموزشی روش های تجربی مطالعه زبان و ادبیات اهواز بهمن ... (برگزار شده)
11 بهمن 97 اهواز
-
کارگاه آموزشی پویاییشناسی سیستمها (System Dynamics) و نرم... (برگزار شده)
04 بهمن 97 تهران
-
کارگاه آموزشی آداب تشریفات تهران آذر 97... (برگزار شده)
01 آذر 97 تهران
-
کارگاه آموزشی انتشار دسترسی آزاد تهران مهر 97... (برگزار شده)
29 مهر 97 تهران
-
کارگاه آموزشی سئو تهران اردیبهشت 97... (برگزار شده)
21 ارديبهشت 97 تهران
-
کارگاه آموزشی زبان بدن تهران فروردین 97... (برگزار شده)
23 فروردين 97 تهران
-
کارگاه آموزشی مجموعه داری تمبر و اقلام پستی بندر عباس اسفند ... (برگزار شده)
21 اسفند 96 بندرعباس
-
دیزاین بیلدر کارگاه آموزشی تهران 96... (برگزار شده)
26 بهمن 96 تهران
-
کارگاه آموزشی آموزش مقررات و قوانین منابع طبیعی اصفهان 96... (برگزار شده)
17 بهمن 96 اصفهان
-
افزایش فروش در شرایط رکود و بازار دشوار(کارگاه آموزشی ) اصفه... (برگزار شده)
16 بهمن 96 اصفهان
-
کارگاه آموزشی دوره تخصصی ارتباط موثر روانشناسی زبان بدن و شخ... (برگزار شده)
26 دی 96 اصفهان
-
کارگاه آموزشی روش های پیشگیری از جعل اصفهان 96... (برگزار شده)
24 دی 96 اصفهان
-
کارگاه آموزشی موفقیت در صنعت فروش اصفهان 96... (برگزار شده)
10 دی 96 اصفهان
-
کارگاه آموزشی اولویت و رتبه بندی نمایندگان فروش 96... (برگزار شده)
22 آبان 96 اصفهان

